Een taalmodel weet veel en kent jouw bedrijf niet. Met RAG laat je het eerst zoeken in je eigen documenten en daarna pas antwoorden. Doe je dat op eigen hardware dan verlaat geen enkele handleiding of procedure je netwerk. Sirris toonde op de tweede begeleidingsgroep van PRINTELLIGENCE hoe zo'n systeem in elkaar zit.
Wat is RAG?
RAG staat voor Retrieval Augmented Generation. In gewone taal: eerst zoeken, dan antwoorden.
Een operator vraagt hoe hij een inktprofiel kopieert naar een andere kleur. Een taalmodel zonder RAG antwoordt uit zijn algemene kennis. Dat antwoord klinkt goed en kan fout zijn voor jouw pers.
Een systeem met RAG zoekt eerst de juiste bladzijde in de handleiding van die pers. Het geeft die bladzijde samen met de vraag aan het taalmodel. Het antwoord steunt dan op je eigen document en je kan nakijken waar het vandaan komt.
Documenten zijn de bekendste bron. RAG kan ook zoeken in machinedata (bijvoorbeeld via MCP) of op het web.
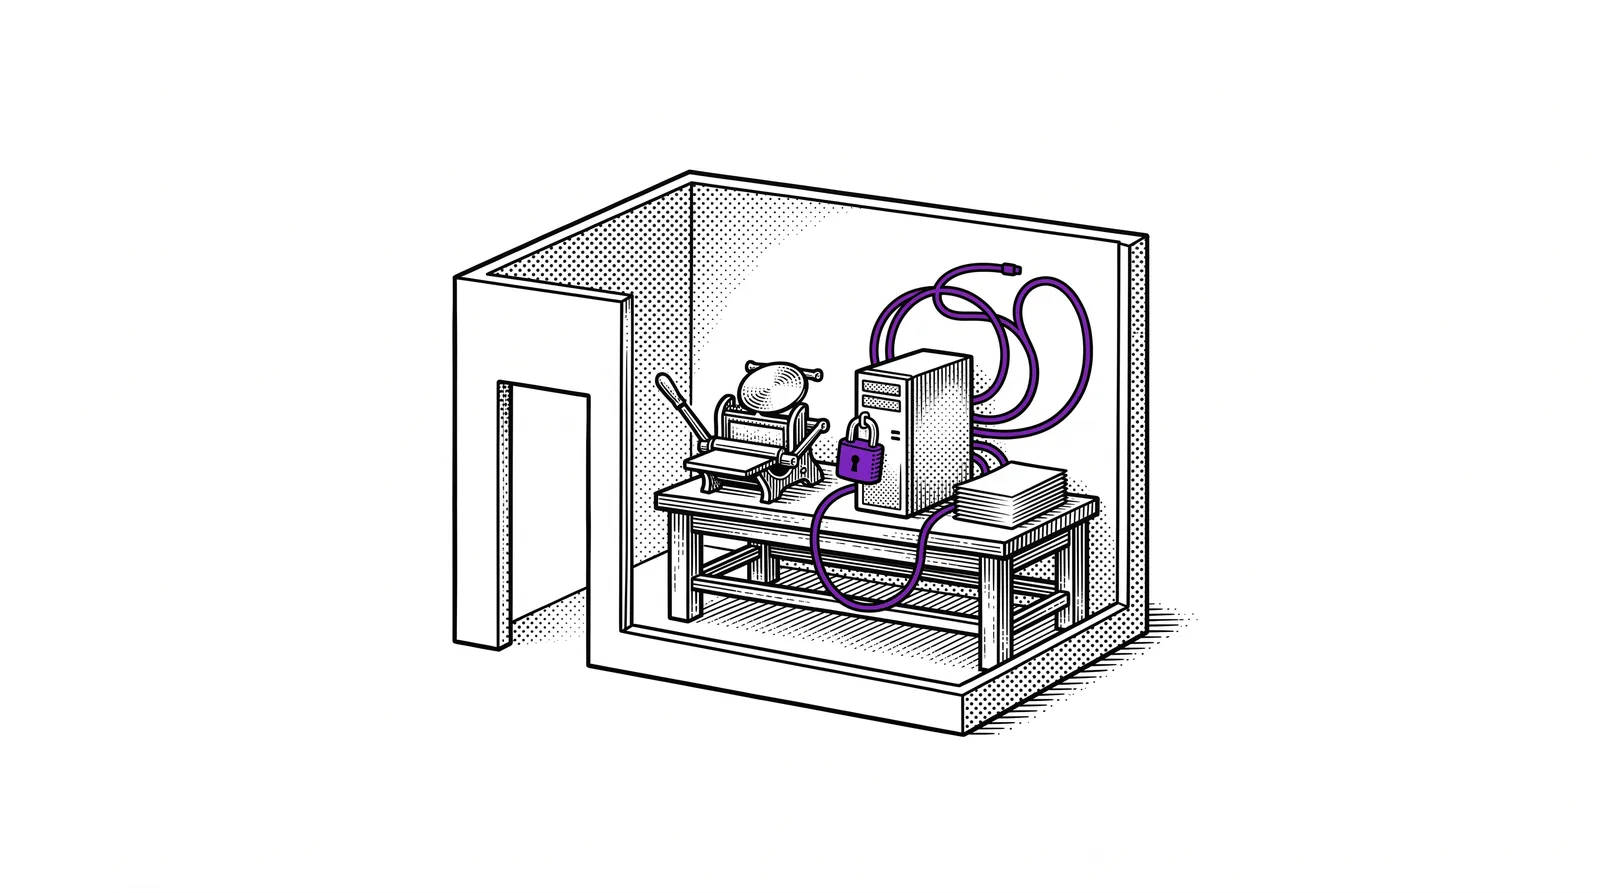
Lokaal betekent dat alles op je eigen hardware draait. Je documenten en de zoekindex staan op je eigen server en het taalmodel draait daar ook. Welke hardware je daarvoor nodig hebt lees je in gids 11 over lokale AI.
Verschil met gids 08: de gids over je eigen drukkerij-assistent bouwt een assistent met kant-en-klare diensten. Deze gids kijkt onder de motorkap en houdt alles binnen de muren.
Een document uploaden of RAG?
Je kan een document ook gewoon in een chat uploaden. Wanneer heb je dan RAG nodig?
Bij uploaden gaat de volledige tekst naar het model. Bij RAG gaan alleen de stukken mee die bij de vraag passen. Sirris zette de twee naast elkaar.
| Vergelijking | Document uploaden in een chat | RAG |
|---|---|---|
| Wat het model leest | De volledige tekst | Enkel de relevante stukken (chunks) |
| Opzet | Weinig werk | Meer technische opzet |
| Nauwkeurigheid | Het meest nauwkeurig | Hangt af van hoe het gebouwd is |
| Rekenkracht | Duur: de hele tekst gaat bij elke vraag mee | Eenmalige verwerking van de documenten |
| Schaal | Beperkt schaalbaar | Goed schaalbaar voor veel documenten |
Uploaden is het nauwkeurigst zolang de tekst in het contextvenster van het model past. Dat venster is het stuk tekst dat een model in één keer kan overzien. Op lokale hardware loop je sneller tegen die grens aan.
Vuistregel: één document en af en toe een vraag? Upload het. Een kast vol handleidingen en elke dag vragen van de vloer? Dan loont RAG.
De bouwstenen in gewone taal
Een RAG-systeem doet vijf dingen na elkaar. De eerste drie gebeuren één keer per document. De laatste twee gebeuren bij elke vraag.
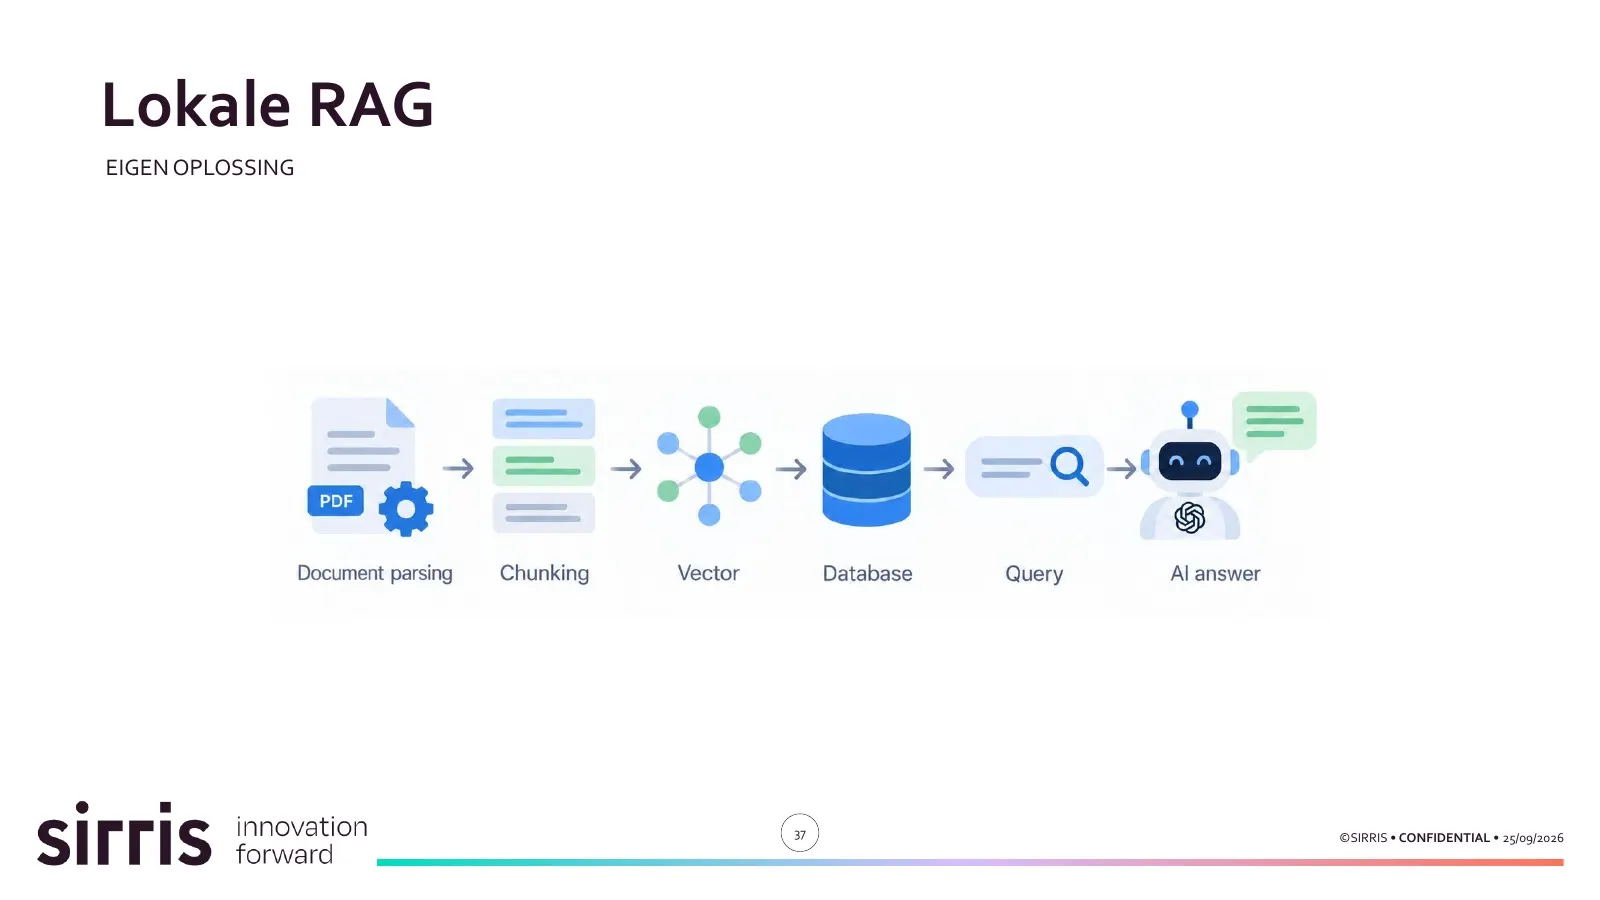
Een pdf is gemaakt om te drukken en niet om te doorzoeken. Een parser haalt de tekst en de tabellen eruit en herkent de tussentitels. Sirris gebruikt daarvoor Docling, een open-sourcetool van IBM. Docling leest pdf en Office-bestanden en zet alles om naar één uniform formaat.
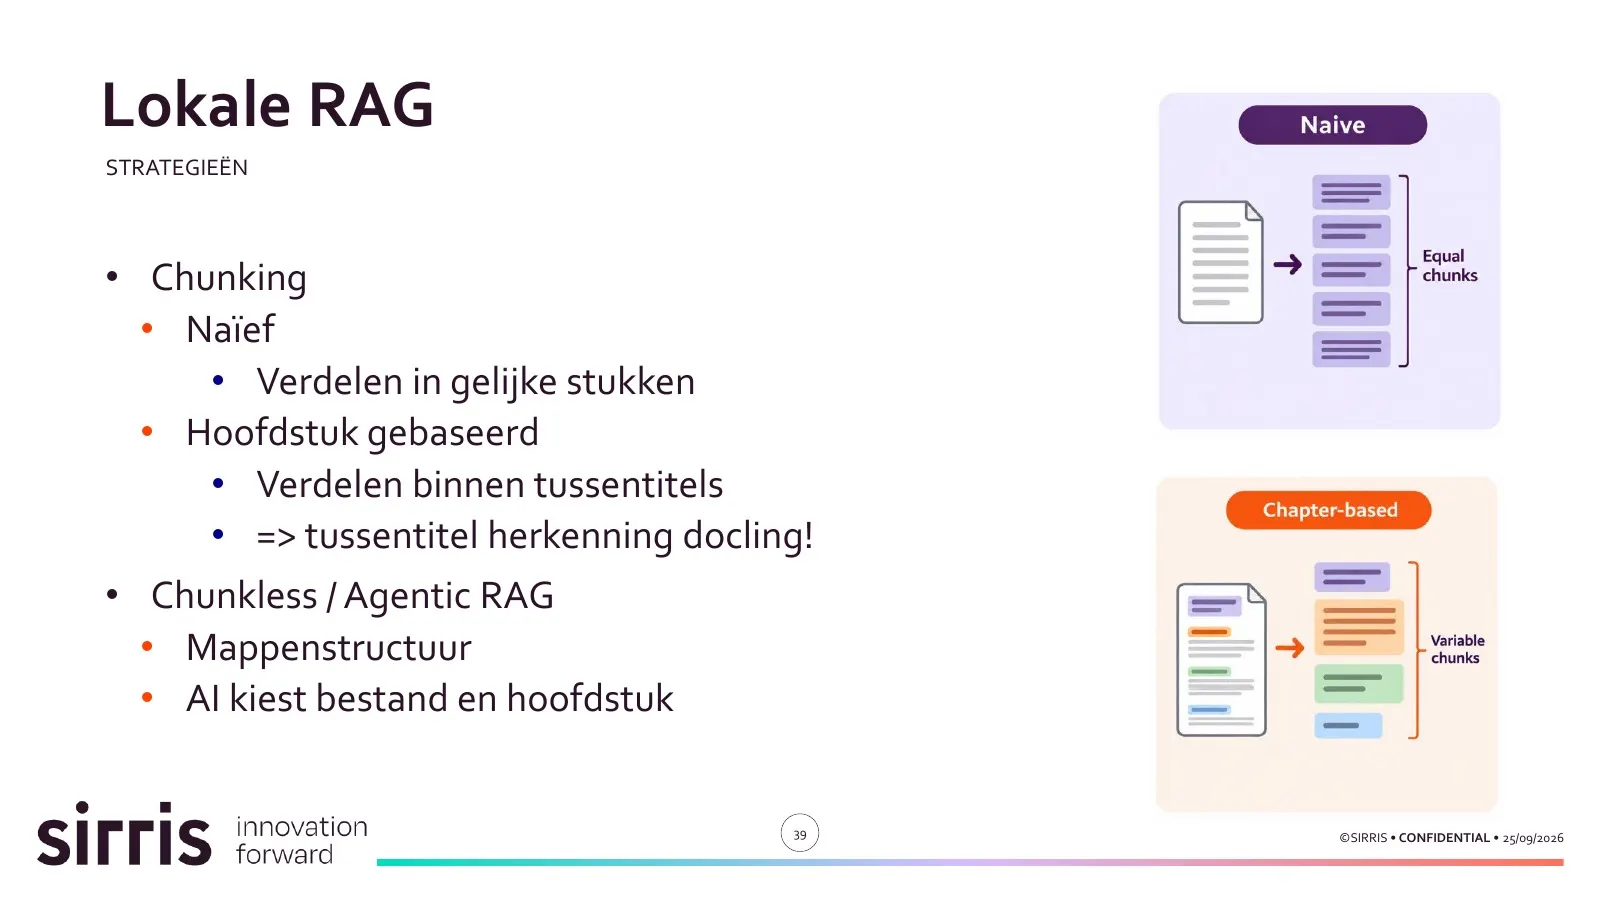
Het document wordt verdeeld in stukken, in het Engels chunks. De naïeve manier knipt in gelijke stukken en snijdt soms midden in een uitleg. Knippen per hoofdstuk werkt beter: elk stuk blijft binnen zijn tussentitel. Daarvoor dienen de tussentitels die Docling herkende.
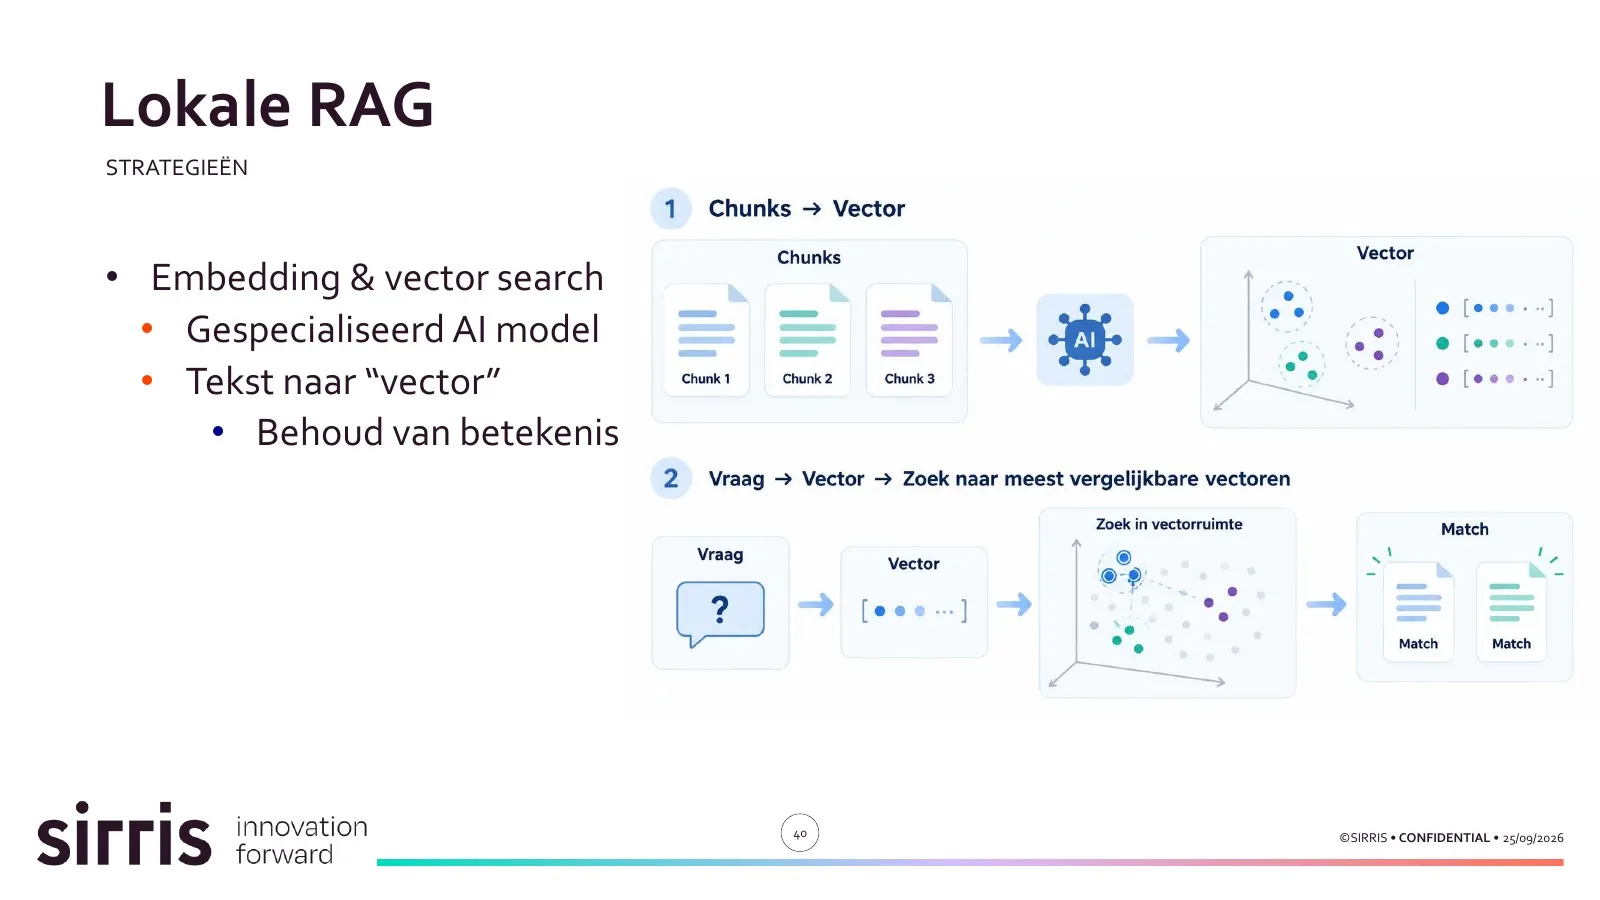
Een gespecialiseerd AI-model zet elk stuk tekst om in een reeks getallen: een vector. De betekenis blijft daarbij bewaard. Stukken die over hetzelfde gaan krijgen vectoren die dicht bij elkaar liggen. Alle vectoren komen in een databank.
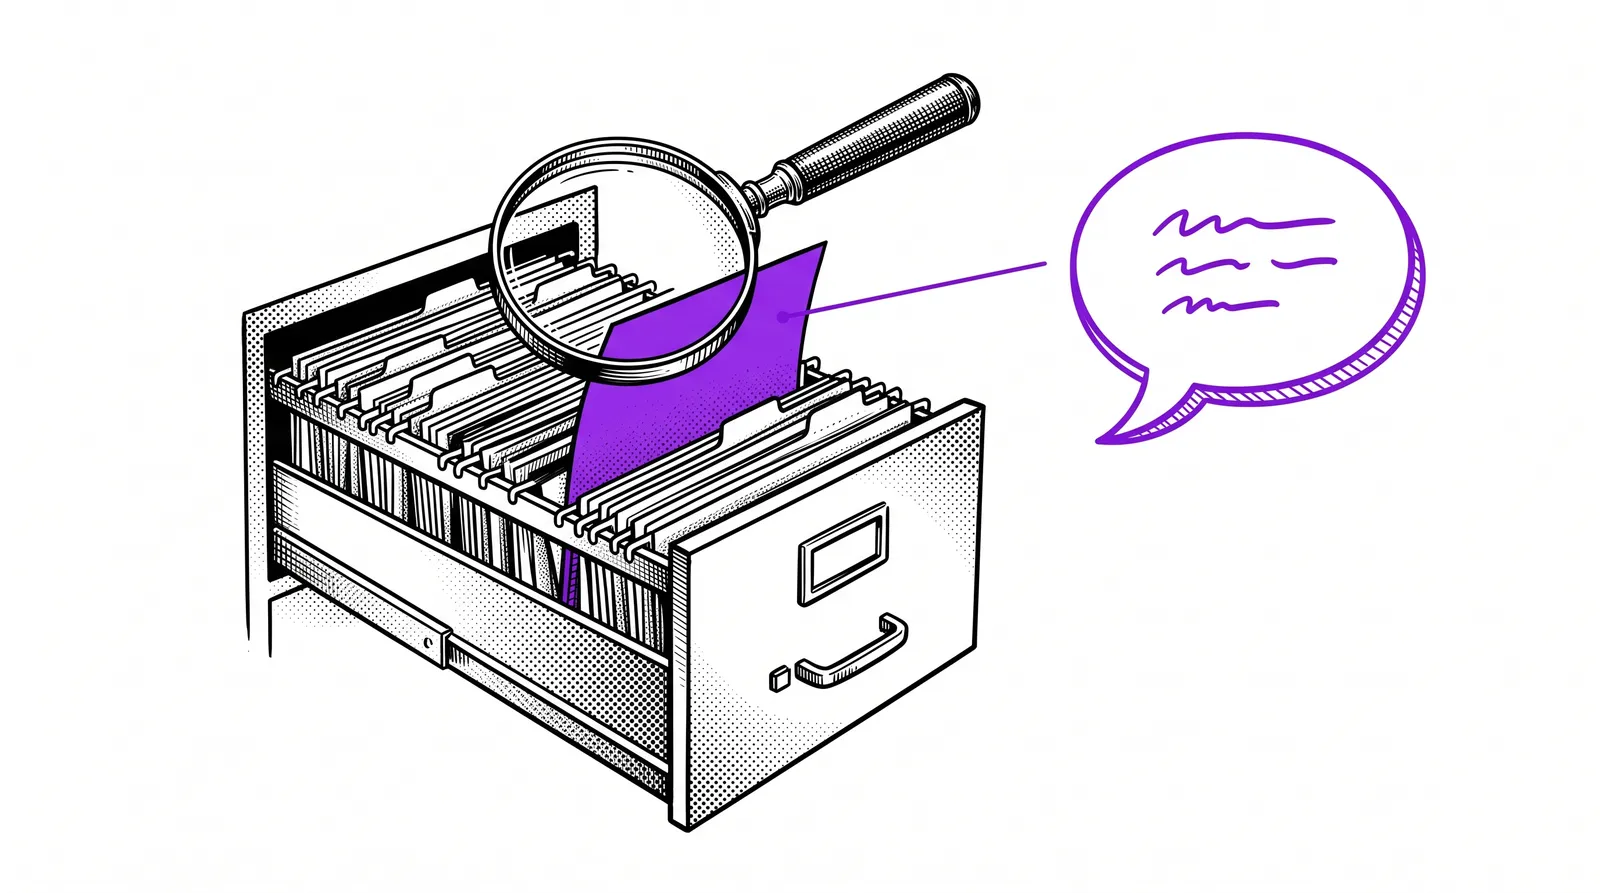
De vraag van de gebruiker wordt op dezelfde manier een vector. Het systeem zoekt de stukken waarvan de vector het meest op die van de vraag lijkt. Het zoekt dus op betekenis en niet op exacte woorden.
Het taalmodel krijgt de vraag samen met de gevonden stukken en schrijft een antwoord. Een goed systeem zet de bron erbij.
Zonder knippen: agentic RAG
Er is ook een aanpak zonder chunks. De documenten staan in een gewone mappenstructuur. De AI kiest zelf welk bestand en welk hoofdstuk ze opent, zoals een collega die weet in welke map hij moet zoeken. Sirris noemt dat chunkless of agentic RAG.
Een bestaand platform of zelf bouwen?
Je hoeft de vijf bouwstenen niet zelf aan elkaar te zetten. Er bestaan open-sourceplatformen die de hele keten aanbieden.
RAGFlow en Dify zijn twee bekende platformen. Je installeert ze en laadt documenten op. Daarna stel je vragen. LlamaIndex is een bouwdoos voor wie zelf programmeert.
Je bepaalt elke stap van het proces zelf en bouwt een scherm dat bij je werkvloer past. Extra functies voeg je toe wanneer je ze nodig hebt. Het vraagt meer tijd en kennis.
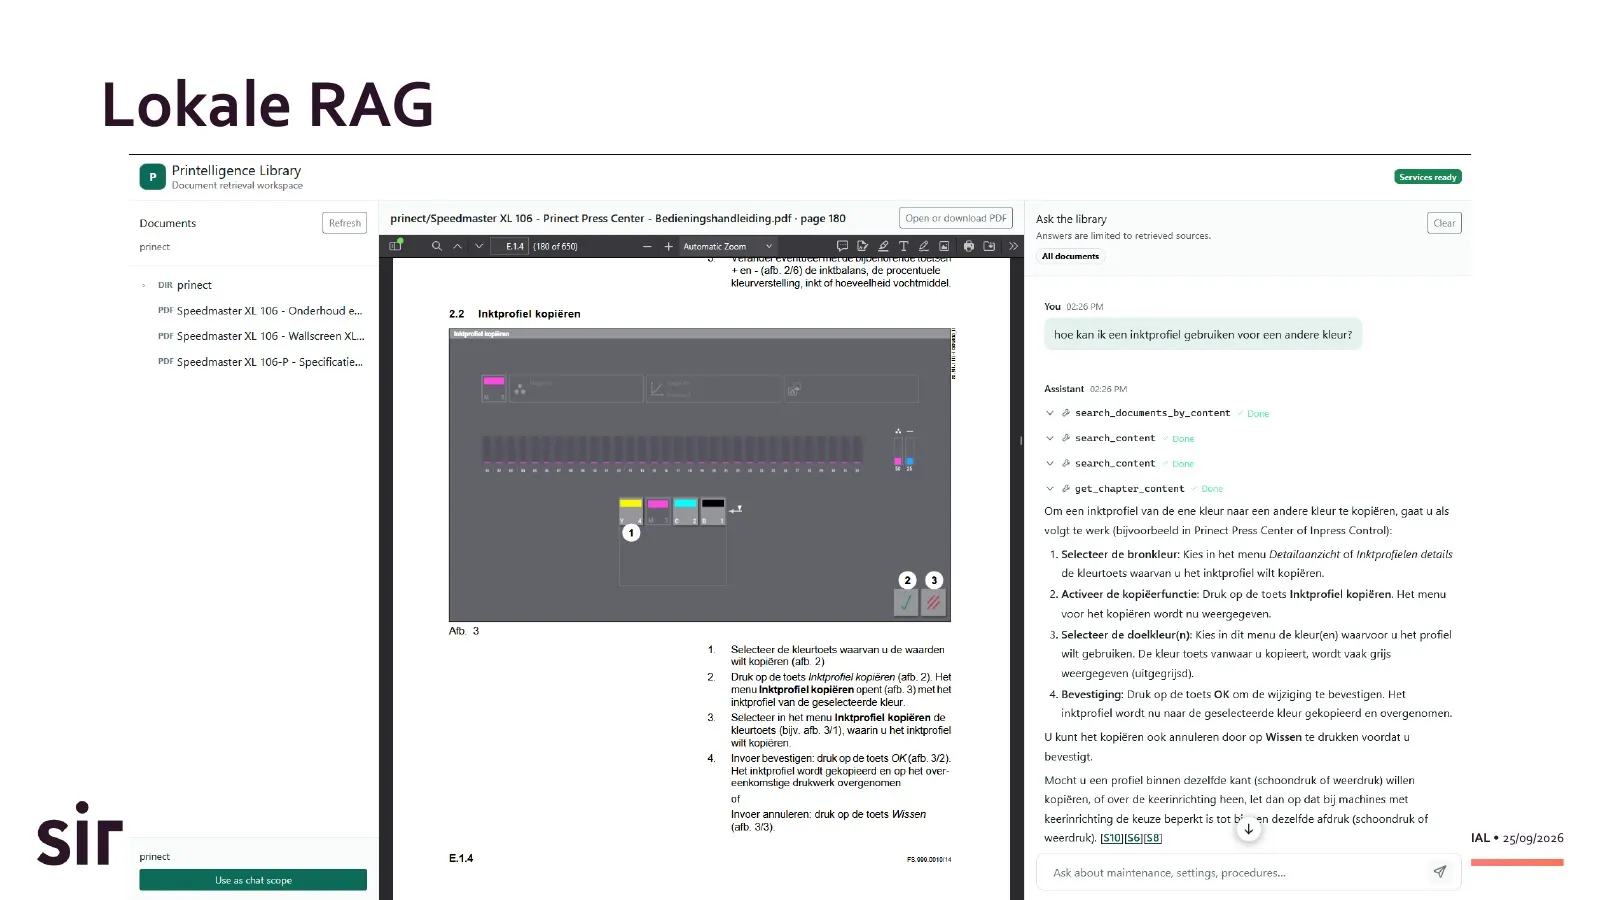
Sirris toonde in de demo een eigen oplossing. In het scherm staan de handleidingen van een Speedmaster XL 106. De vraag was: “hoe kan ik een inktprofiel gebruiken voor een andere kleur?” Het antwoord kwam in vier stappen met de bronnen eronder. Ernaast opende de juiste bladzijde van de bedieningshandleiding, een document van 650 bladzijden.
Ons advies: begin met een bestaand platform. Je leert wat werkt met je eigen documenten zonder eerst maanden te bouwen. Zelf bouwen komt later, als je tegen de grenzen van het platform botst.
Goede toepassingen in een drukkerij
RAG werkt het best op documenten die vaak geraadpleegd worden en zelden veranderen.
Honderden bladzijden per pers, vaak in een map die niemand opent. De operator stelt zijn vraag aan de pers en krijgt de juiste bladzijde.
Hoe stel je de vouwmachine in voor dit formaat? Een nieuwe medewerker vindt het antwoord zonder een collega te storen.
Wat doe je bij een kleurafwijking? De procedure bestaat al. Nu vindt iemand ze ook op het moment dat het telt.
Welke toeslag geldt voor spoed? De calculator krijgt de regel met de bron erbij en hoeft niet te zoeken in oude mails.
Die toepassingen komen uit de sector zelf. Op de eerste begeleidingsgroep in maart stonden “machinehandleidingen digitaal doorzoekbaar maken” en een “chatbot aan de machine” al bij de 75 ideeën.
Een vraag over cijfers is geen vraag voor RAG
RAG op documenten antwoordt op vragen zoals “hoe doe ik dit?” of “wat zegt de procedure?”. Een vraag zoals “hoeveel papierbreuken hadden we deze week?” gaat over cijfers. Daarvoor laat je de AI een berekening maken op je productiegegevens. Hoe dat werkt lees je in gids 12: praten met je productiedata.
Waar het misloopt
Een RAG-systeem is zo goed als de documenten die je erin stopt. Vier problemen komen steeds terug.
Een gescande handleiding is een foto van tekst. Zonder tekstherkenning vindt het systeem er niets in. Tabellen en schema's gaan vaak verloren. Test het inlezen eerst op je moeilijkste document.
Het systeem weet niet welke versie geldt. Staat de oude procedure er nog in dan krijg je met evenveel overtuiging het oude antwoord. Wijs iemand aan die de documenten beheert.
Een antwoord zonder bron kan je niet controleren. Eis bij elk antwoord het document en de bladzijde. In de demo van Sirris stonden de bronnen onder het antwoord.
Staat het antwoord niet in je documenten dan gaat een taalmodel soms gokken. Stel het systeem zo in dat het alleen antwoordt met wat het vond. Vindt het niets dan moet het dat zeggen.
Starten in vier stappen
Begin klein en met echte vragen van de vloer.
Neem de handleidingen van één pers of de procedures van één afdeling. Verzamel tien vragen die operatoren echt stellen.
Upload één document in een chat en stel je tien vragen. Zijn de antwoorden goed? Dan weet je dat het document bruikbaar is.
Installeer RAGFlow of Dify op een testtoestel en laad je set op. Wil je alles binnen houden? Koppel er dan een lokaal model aan (zie gids 11).
Laat operatoren dezelfde tien vragen stellen. Controleer bij elk antwoord de bron. Noteer wat fout ging en verbeter eerst de documenten.
Meer lezen en bronnen
De inhoud van deze gids komt uit de presentatie “Lokale AI en lokale RAG” die Sirris gaf op de tweede begeleidingsgroep van PRINTELLIGENCE, op 24 september 2026 op de Corda Campus in Hasselt. De vergelijkingstabel en de bouwstenen zijn overgenomen van de slides. De toepassingen in een drukkerij en de valkuilen zijn een aanvulling van het projectteam, net als de vier startstappen.
Alle 25 slides om door te bladeren of als pdf te downloaden, bij het verslag van begeleidingsgroep 2.
Een assistent op je eigen documentatie, met aandacht voor de kennisbank en het testen.
Welk model en welke hardware je nodig hebt om alles in huis te draaien.
Hoe een AI-assistent naast documenten ook je systemen bereikt.
De 75 ideeën uit de sector, met doorzoekbare handleidingen en kennisbehoud.
Wat een embedding of een contextvenster is, in gewone taal.
RAG in vier woorden: eerst zoeken, dan antwoorden.