Een taalmodel hoeft niet in de cloud te draaien. Je kan er een downloaden en op je eigen toestel laten werken, zonder dat je data het gebouw verlaat. Sirris toonde op de tweede begeleidingsgroep van PRINTELLIGENCE wat daar vandaag voor nodig is. Deze gids vat het samen en helpt je beslissen of het iets is voor jouw drukkerij.
Waarom zou je AI lokaal draaien?
Bij ChatGPT of Claude reist je vraag naar een datacenter van de leverancier. Bij lokale AI staat het model op een toestel in je eigen bedrijf.
Voor veel taken is de cloud prima. Je betaalt een abonnement en je krijgt het slimste model dat er is. Voor sommige data wil je dat liever niet. Er zijn vier redenen om een model in huis te halen.
Calculaties en klantbestanden verlaten je netwerk niet. Je hoeft niemand te vragen wat er met je tekst gebeurt.
Je koopt hardware en betaalt stroom. Er komt geen factuur per vraag of per gebruiker bij, ook niet voor een taak die elke nacht duizenden documenten leest.
Een clouddienst kan zijn prijs of zijn model aanpassen. Een model dat je zelf downloadde blijft hetzelfde tot jij het vervangt.
Valt de verbinding weg dan draait een lokaal model gewoon door. Dat telt voor een toepassing aan de pers.
Eerlijk blijven: lokale AI is niet gratis en niet het slimste wat er bestaat. Je ruilt een stuk intelligentie voor controle. De rest van deze gids toont hoe groot die ruil is.
Open-weight is niet hetzelfde als lokaal
Een model dat je mag downloaden is nog geen model dat bij jou kan draaien.
Een taalmodel bestaat uit miljarden getallen: de parameters, in het Engels weights. Bij een open-weight model stelt de maker die getallen gratis ter beschikking. Je mag ze downloaden en zelf draaien. Zulke modellen komen van bedrijven en van onderzoeksgroepen over de hele wereld.
| Regio | Bekende open-weight modellen |
|---|---|
| Verenigde Staten | GPT-OSS, Gemma, Llama |
| China | Qwen, DeepSeek, GLM, Kimi |
| Europa | Mistral |
Ze staan op Hugging Face, een soort bibliotheek voor AI-modellen. Er staan er intussen meer dan drie miljoen. De ranglijst van de beste modellen verandert elke maand. Wat je vandaag kiest is dus snel ingehaald. Dat is geen ramp: een nieuwer model downloaden is weinig werk.
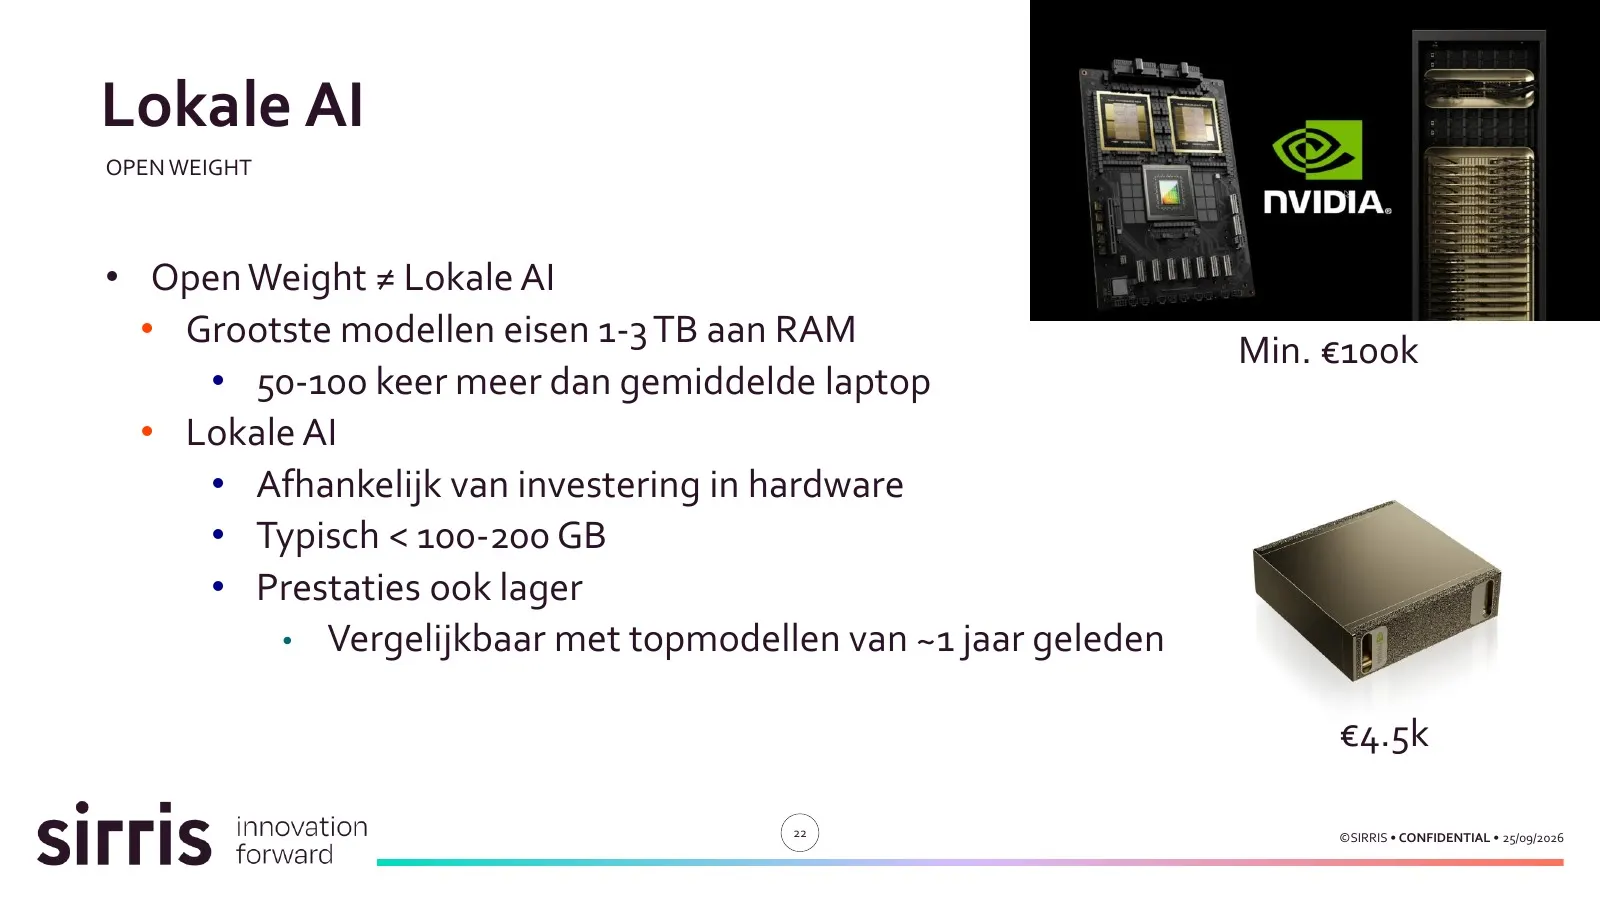
De grootste open modellen vragen één tot drie terabyte werkgeheugen. Dat is vijftig tot honderd keer meer dan een gemiddelde laptop heeft. De hardware daarvoor kost minstens honderdduizend euro.
Lokale AI is wat op betaalbare hardware past. Meestal gaat het om modellen die minder dan honderd tot tweehonderd gigabyte vragen. Ze presteren lager dan de grootste. Sirris vergelijkt ze met de topmodellen van ongeveer een jaar geleden.
Voor veel werk op de productievloer is dat ruim genoeg. Een melding samenvatten of een vraag over een handleiding beantwoorden vraagt geen topmodel.
Meer dan taalmodellen
Open-weight gaat over meer dan chatten. Er bestaan ook modellen die spraak omzetten naar tekst en tekst naar spraak. Andere lezen documenten in of maken embeddings, de bouwsteen om in je eigen documenten te zoeken (zie gids 14 over lokale RAG). Zo'n gespecialiseerd model is klein. Het doet zijn ene taak vaak beter dan het algemene model van een groot AI-lab.
Geheugen beslist: hoe groot en hoe snel
Een taalmodel schrijft zijn antwoord token per token. Een token is een stukje van een woord. Voor elk token moet de computer alle parameters van het model doorlopen.
Daarom is het werkgeheugen (RAM) de beperkende factor. Twee eigenschappen tellen.
Bepaalt hoe groot het model mag zijn. Past het model niet in het geheugen dan draait het niet.
Bepaalt hoe snel het model antwoordt. Trager geheugen geeft minder tokens per seconde.
Uit het voorbeeld van Sirris haal je twee vuistregels. Reken ongeveer één gigabyte per miljard parameters. Deel daarna de snelheid van het geheugen door de grootte van het model: dat geeft het aantal tokens per seconde.
| Voorbeeld 1 | Qwen 3.5 9B | Qwen 3.5 27B |
|---|---|---|
| Aantal parameters | 9 miljard | 27 miljard |
| Grootte in het geheugen (8 bit) | ongeveer 10 GB | ongeveer 30 GB |
| Past in 16 GB RAM | ja | nee |
| Past in 64 GB RAM | ja | ja |
| Geheugen van 100 GB/s (gewone laptop) | 10 tokens/s | 3,3 tokens/s |
| Geheugen van 450 GB/s (grafische kaart voor gamers) | 45 tokens/s | 15 tokens/s |
| Geheugen van 1800 GB/s (professionele grafische kaart) | 180 tokens/s | 60 tokens/s |
Ter vergelijking: GPT en Claude halen in de cloud 40 tot 80 tokens per seconde. Met het grote model op een gewone laptop zie je de woorden één voor één verschijnen. Voor een taak die 's nachts loopt is dat geen probleem. Voor een gesprek aan de pers wel.
Niet elk model gebruikt al zijn parameters
Nieuwere modellen zijn slimmer gebouwd. Qwen 3.6 35B A3B telt 35 miljard parameters en gebruikt er per token maar 3 miljard. Je hebt nog altijd geheugen nodig voor het hele model. De snelheid hangt alleen af van het actieve deel.
| Voorbeeld 2 | Qwen 3.6 27B | Qwen 3.6 35B A3B |
|---|---|---|
| Parameters in totaal | 27 miljard | 35 miljard |
| Actieve parameters per token | 27 miljard | 3 miljard |
| Grootte in het geheugen (8 bit) | ongeveer 30 GB | ongeveer 38 GB |
| Past in 16 GB RAM | nee | nee |
| Past in 64 GB RAM | ja | ja |
| Geheugen van 100 GB/s | 3,3 tokens/s | 33 tokens/s |
| Geheugen van 450 GB/s | 15 tokens/s | 150 tokens/s in theorie, 50 tot 100 in de praktijk |
| Geheugen van 1800 GB/s | 60 tokens/s | 600 tokens/s in theorie, 120 tot 150 in de praktijk |
Bij die hoge snelheden is het geheugen niet langer de rem. De rekenkracht van de chip wordt dan opnieuw de beperkende factor. Vandaar het verschil tussen theorie en praktijk.
De tabellen rekenen met 8 bit per parameter. Apps zoals LM Studio bieden ook sterker samengedrukte versies van een model aan. Die vragen minder geheugen en verliezen een beetje kwaliteit.
Onthoud: een groter model is slimmer en trager. Een model met weinig actieve parameters geeft je de kennis van een groot model aan de snelheid van een klein.
Welke hardware kies je?
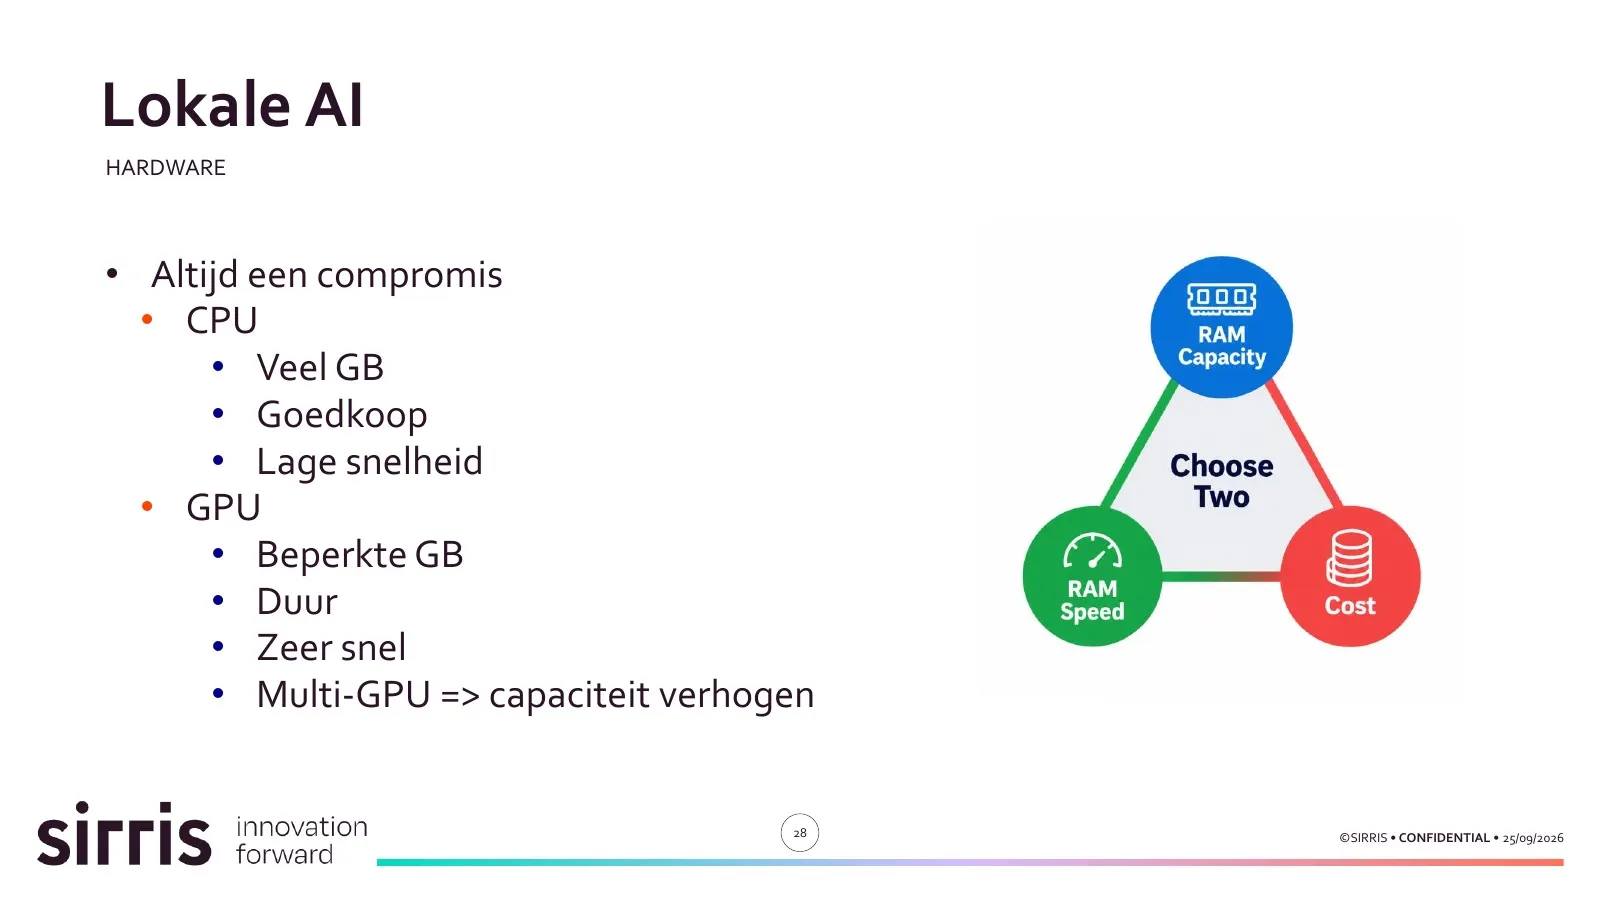
Hardware voor lokale AI is altijd een compromis tussen capaciteit en snelheid. De prijs beslist hoeveel je van elk krijgt.
Gewoon werkgeheugen naast de processor (CPU) is goedkoop en je krijgt er veel gigabytes voor. Het is wel traag. Het geheugen van een grafische kaart (GPU) is zeer snel. Het is ook duur en je krijgt er weinig van. Wie meer capaciteit wil zet meerdere grafische kaarten samen.
Sirris wees twee soorten toestellen aan met een goede balans: de DGX Spark van Nvidia en de Mac mini of Mac Studio van Apple. In de tabel staat ook een losse grafische kaart als vergelijking.
| Toestel | Geheugen | Snelheid van het geheugen | Type GPU | Richtprijs |
|---|---|---|---|---|
| DGX Spark | 128 GB | 273 GB/s | Nvidia CUDA | vanaf 4.500 euro |
| Mac mini M5 Pro | 64 GB | 307 GB/s | Apple | 3.200 euro |
| Mac Studio M5 Max | 128 GB | 614 GB/s | Apple | 5.900 euro |
| Mac Studio M5 Ultra | 256 GB | 1200 GB/s | Apple | 11.000 euro |
| Nvidia RTX 5090 (losse kaart) | 32 GB | 1800 GB/s | Nvidia CUDA | ongeveer 5.500 euro |
Let op de datum. De prijzen en specificaties komen uit de presentatie van Sirris en zijn van september 2026. Ze verouderen snel. Vraag een actuele prijs voor je beslist.
Zo lees je de tabel:
- De DGX Spark geeft veel geheugen voor zijn prijs en heeft het traagste geheugen van de vijf. Hij werkt met Nvidia CUDA. Dat heeft volgens Sirris de beste compatibiliteit met AI-software.
- De Mac mini en de Mac Studio zijn sneller. Ze werken zonder CUDA. Controleer dus vooraf of de software die je wil gebruiken op Apple draait.
- De Mac Studio M5 Ultra combineert veel geheugen met een hoge snelheid. Daar betaal je ook voor.
- De RTX 5090 is het snelst en heeft het minste geheugen. Het is een losse kaart: je hebt er nog een computer rond nodig.
Een rekenvoorbeeld met de vuistregel uit het vorige hoofdstuk. Een model van 30 GB op een DGX Spark: 273 gedeeld door 30 geeft ongeveer 9 tokens per seconde. Op een Mac Studio M5 Max kom je op ongeveer 20. Het zijn ruwe schattingen. Test met je eigen taak voor je koopt.
Zelf starten op je laptop in vier stappen
Je hoeft niets te kopen om te weten of lokale AI iets voor je is. Begin op de laptop die je hebt.
LM Studio is een gebruiksvriendelijke app waarmee je modellen downloadt en ermee chat. Je hebt er geen commandoregel voor nodig.
Sirris raadt aan om klein te starten: Qwen 3.5 4B (ongeveer 4 GB) of Gemma E2B (ongeveer 5 GB). Die passen op een gewone laptop.
Neem een tekst uit je eigen bedrijf, bijvoorbeeld een werkinstructie of een klachtenmail. Vraag een samenvatting of stel er vragen over. Alles blijft op je laptop, dus je mag echte teksten gebruiken. Noteer waar het antwoord goed is en waar het de mist ingaat.
Werkt het voor jouw taak? Dan loont het om naar hardware te kijken. Voor een server die meerdere collega's tegelijk bedient bestaan vLLM en SGLang. Die zijn technischer om op te zetten en bieden meer modellen.
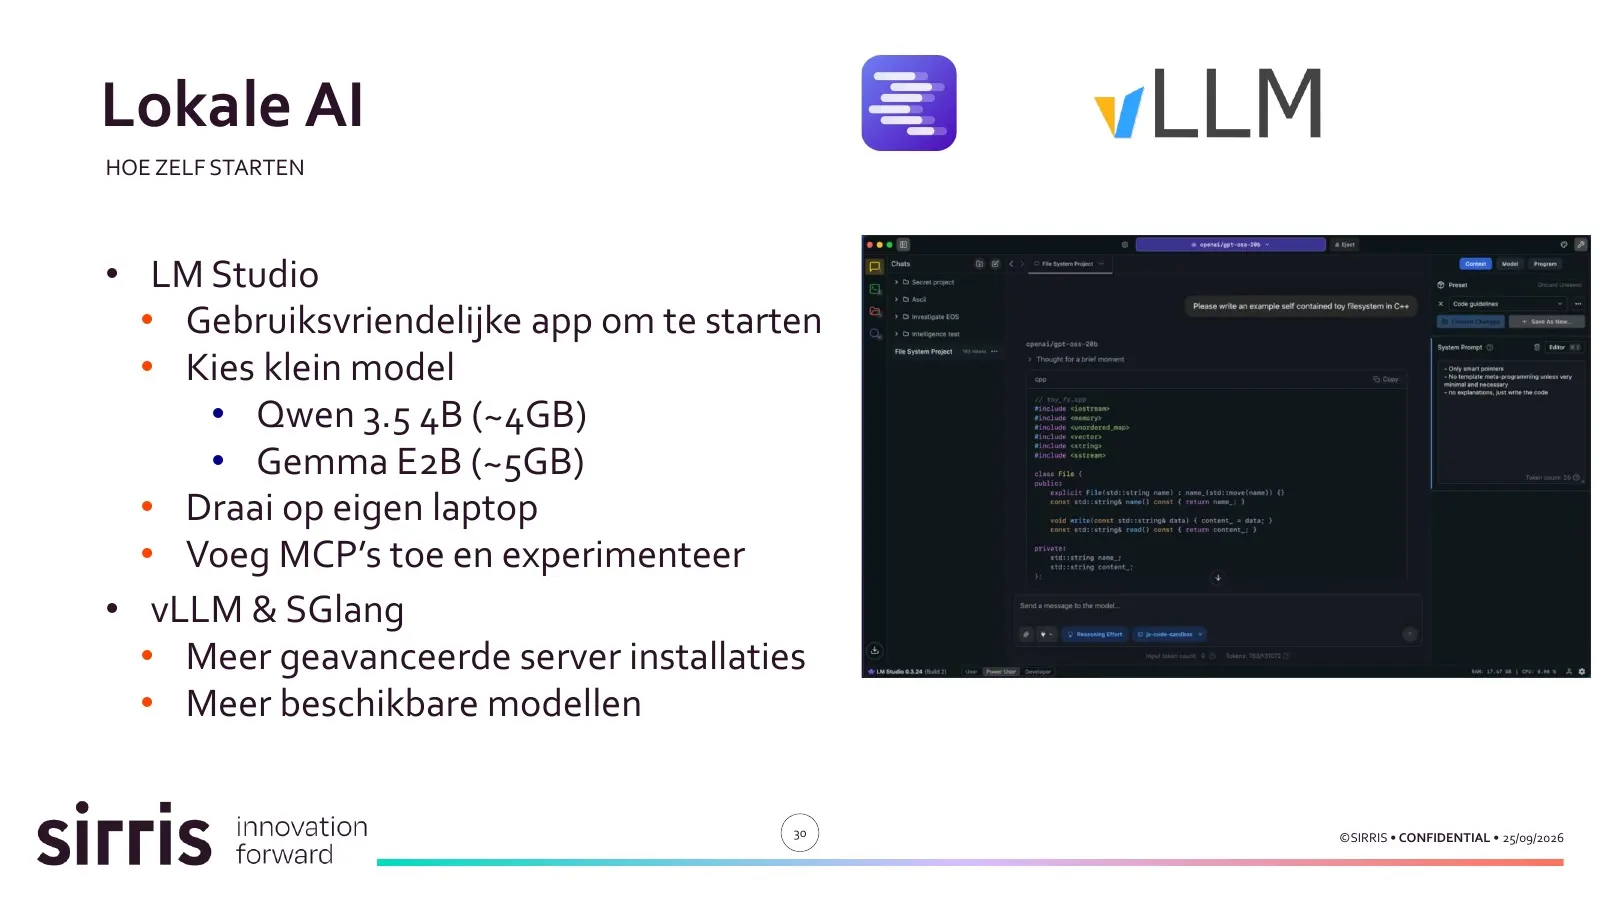
Wie verder wil experimenteren kan in LM Studio ook MCP's toevoegen. Zo krijgt het lokale model toegang tot je bestanden of tot andere tools. Hoe dat werkt lees je in de MCP-gids.
Waar lokaal tekortschiet en hoe hybride werken helpt
Niet elke taak past op een lokaal model. Sirris maakt een onderscheid tussen operationele en strategische AI.
Dagelijkse vragen over machinedata en planning. Een hulp voor vraag en antwoord aan de pers hoort hier ook bij. Een lokaal model past hier goed.
Data-analyse over het hele bedrijf of het beheer van je infrastructuur. Hier wil je het slimste model en dat draait in de cloud.
Daar wringt het. Strategische vragen gaan vaak over je gevoeligste data, zoals marges en kostprijzen. Net die data wil je binnen houden. Het slimste model staat buiten en een lokaal model is voor zo'n analyse vaak te zwak.
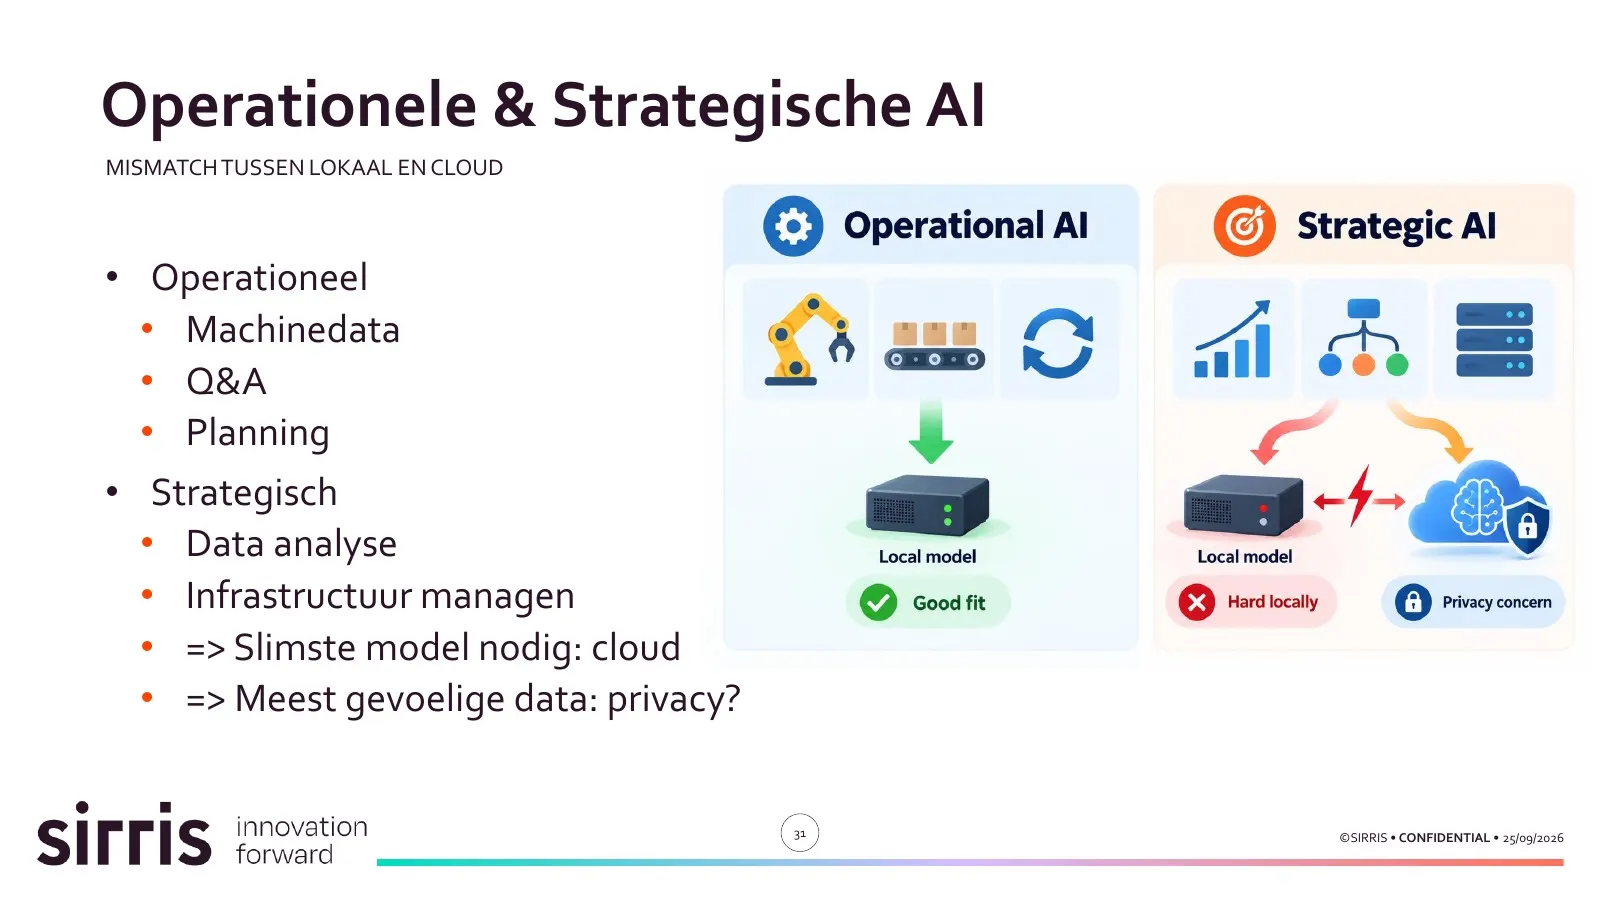
Er zijn vier manieren om daarmee om te gaan.
Je investeert in zwaardere hardware of je wacht. Wat vandaag alleen in de cloud kan draait later mogelijk ook lokaal.
Een lokaal model anonimiseert eerst je data: namen en andere herkenbare gegevens verdwijnen. De anonieme versie gaat naar een cloudmodel voor de analyse of voor een prototype.
Je gebruikt een cloudmodel via een API en kiest bewust. Dat kan een Europees model zijn zoals Mistral of een model via een tussendienst zoals OpenRouter. Kijk naar twee dingen: in welke regio je data verwerkt wordt en of de aanbieder je vragen bewaart (logging).
Je huurt hardware per uur en draait er je eigen model op. Je krijgt de capaciteit van een grote server zonder de aankoop.
Hybride in één zin: lokaal wat gevoelig is of elke dag terugkomt, de cloud voor wat het slimste model vraagt.
Checklist: is lokale AI iets voor mijn drukkerij?
Beantwoord deze zes vragen met ja of nee.
- Werk je met data die het gebouw niet mag verlaten, zoals calculaties of klantbestanden?
- Heb je een taak die elke dag terugkomt en veel tekst verwerkt?
- Is een model van het niveau van vorig jaar goed genoeg voor die taak?
- Is er iemand in huis die een server wil beheren, met updates en back-ups?
- Heb je een budget van enkele duizenden euro's voor hardware?
- Wil je minder afhankelijk zijn van één leverancier?
Vier keer ja of meer: doe de laptoptest uit hoofdstuk 5 en reken daarna uit welke hardware je nodig hebt.
Twee keer ja of minder: een clouddienst met duidelijke afspraken over regio en logging is eenvoudiger.
Zit je ertussen? Begin met de laptoptest. Die kost alleen tijd.
Meer lezen en bronnen
De inhoud van deze gids komt uit de presentatie “Lokale AI en lokale RAG” die Sirris gaf op de tweede begeleidingsgroep van PRINTELLIGENCE, op 24 september 2026 op de Corda Campus in Hasselt. De tabellen en de prijzen zijn overgenomen van de slides. De uitleg eromheen en de checklist zijn van het projectteam. De rekenvoorbeelden met tokens per seconde zijn schattingen en geen metingen.
Alle 25 slides om door te bladeren of als pdf te downloaden, bij het verslag van begeleidingsgroep 2.
Je eigen documenten bevragen met een model dat in huis draait.
Hoe een AI-assistent veilig aan je bestanden en tools hangt.
Een assistent bouwen op je eigen documentatie.
De drukkerij bouwde op een eigen server in huis kleine toepassingen die alleen lezen in het ERP en de machinedata.
Wat een token of een embedding is, in gewone taal.
Wat op betaalbare hardware draait haalt ongeveer het niveau van de topmodellen van een jaar geleden. Voor veel taken op de werkvloer is dat ruim genoeg.