Hoeveel papierbreuken hadden we deze week? Een ploegleider wil op zo'n vraag een antwoord zonder eerst een rapport aan te vragen. Op de tweede begeleidingsgroep van PRINTELLIGENCE toonde het projectteam hoe AI die vraag vertaalt naar een berekening op je productiegegevens. Deze gids legt uit hoe dat werkt en wat je ervoor nodig hebt.
Een vraag in gewone taal in plaats van een query
Je productiedata zit in databanken. Wie er iets uit wil halen schrijft een query: een opdracht in de taal van de databank.
Dat kan niet iedereen. Vaak is het één persoon in het bedrijf. De anderen wachten op een rapport of kijken in een export die al een week oud is.
Praten met je productiedata draait dat om. Je stelt je vraag zoals je ze aan een collega zou stellen. De AI zoekt uit welke gegevens daarvoor nodig zijn en schrijft zelf de query. Je krijgt het antwoord terug met de bron erbij.
In het kort: jij stelt de vraag en de AI schrijft de query. Daarna controleer jij de bron. De werkvraag blijft het vertrekpunt.
Twee vragen van de werkvloer
Het projectteam werkte twee vragen uit die elke drukkerij herkent. De eerste is een telvraag. De tweede is een rekenvraag.
Vraag 1: hoeveel papierbreuken hadden we deze week?
Om te kunnen tellen moet de AI vier dingen weten.
- Waar breuken geregistreerd worden. Bij Drukkerij Moderna loggen de rotatiepersen van manroland elke stilstand en elke papierbreuk tot op de minuut.
- Wat “deze week” betekent. Begint de week op maandagochtend of bij de nachtploeg van zondag?
- Over welke persen het gaat. Alle persen samen of elke pers apart?
- Hoe een breuk in de data heet. Dat kan een foutcode zijn of een type stilstand.
Met die kennis schrijft de AI een query. Ze ziet er ongeveer zo uit. De namen van de tabel en de kolommen zijn een voorbeeld: in jouw systeem heten ze anders.
SELECT pers, COUNT(*) AS aantal_breuken
FROM stilstanden
WHERE type = 'papierbreuk'
  AND start >= '2026-09-21'
  AND start <  '2026-09-28'
GROUP BY pers;
Je hoeft zo'n query niet te kunnen schrijven. Het helpt wel als je ze kan lezen. Hier staat: tel de stilstanden van het type papierbreuk in de week van 21 september en toon het aantal per pers.
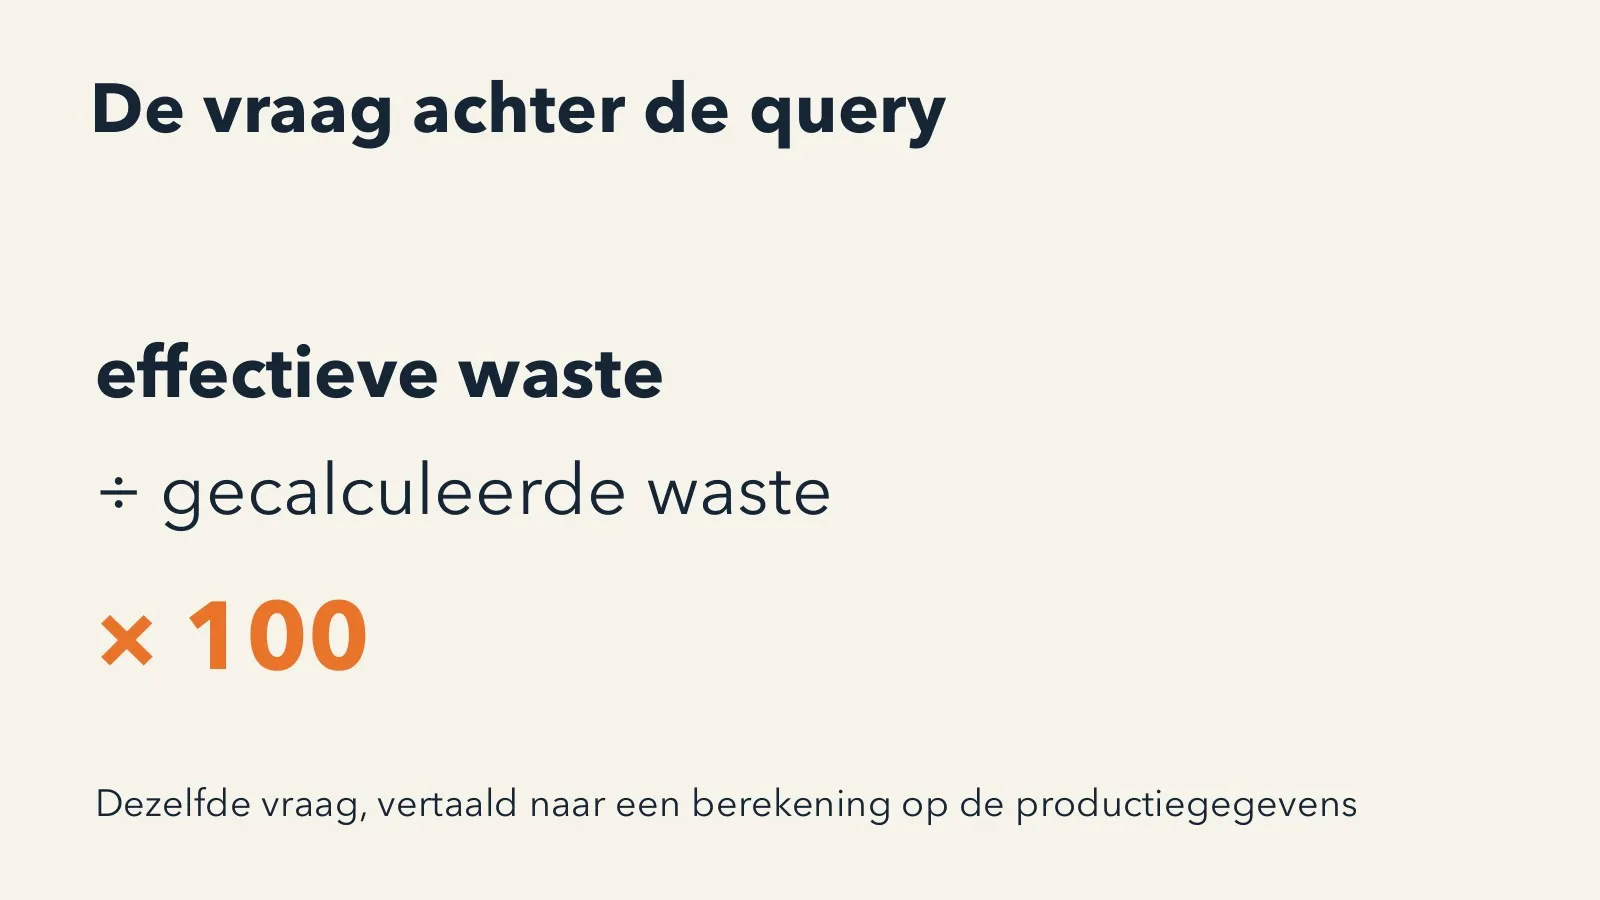
Vraag 2: hoeveel procent effectieve waste tegenover de gecalculeerde waste?
De formule is eenvoudig.
effectieve waste ÷ gecalculeerde waste × 100
Een rekenvoorbeeld met ronde getallen. De calculatie voorzag 1.000 vel inschiet en er gingen 1.200 vel verloren. 1.200 gedeeld door 1.000 maal 100 geeft 120 procent. Je zat dus 20 procent boven de calculatie.
De moeilijkheid zit in de twee bronnen. De gecalculeerde waste staat in de calculatie of in het ERP. De effectieve waste komt van de pers of uit de productieregistratie. De AI moet beide bronnen kunnen bereiken en ze aan elkaar koppelen, bijvoorbeeld via het ordernummer.
Wat je nodig hebt
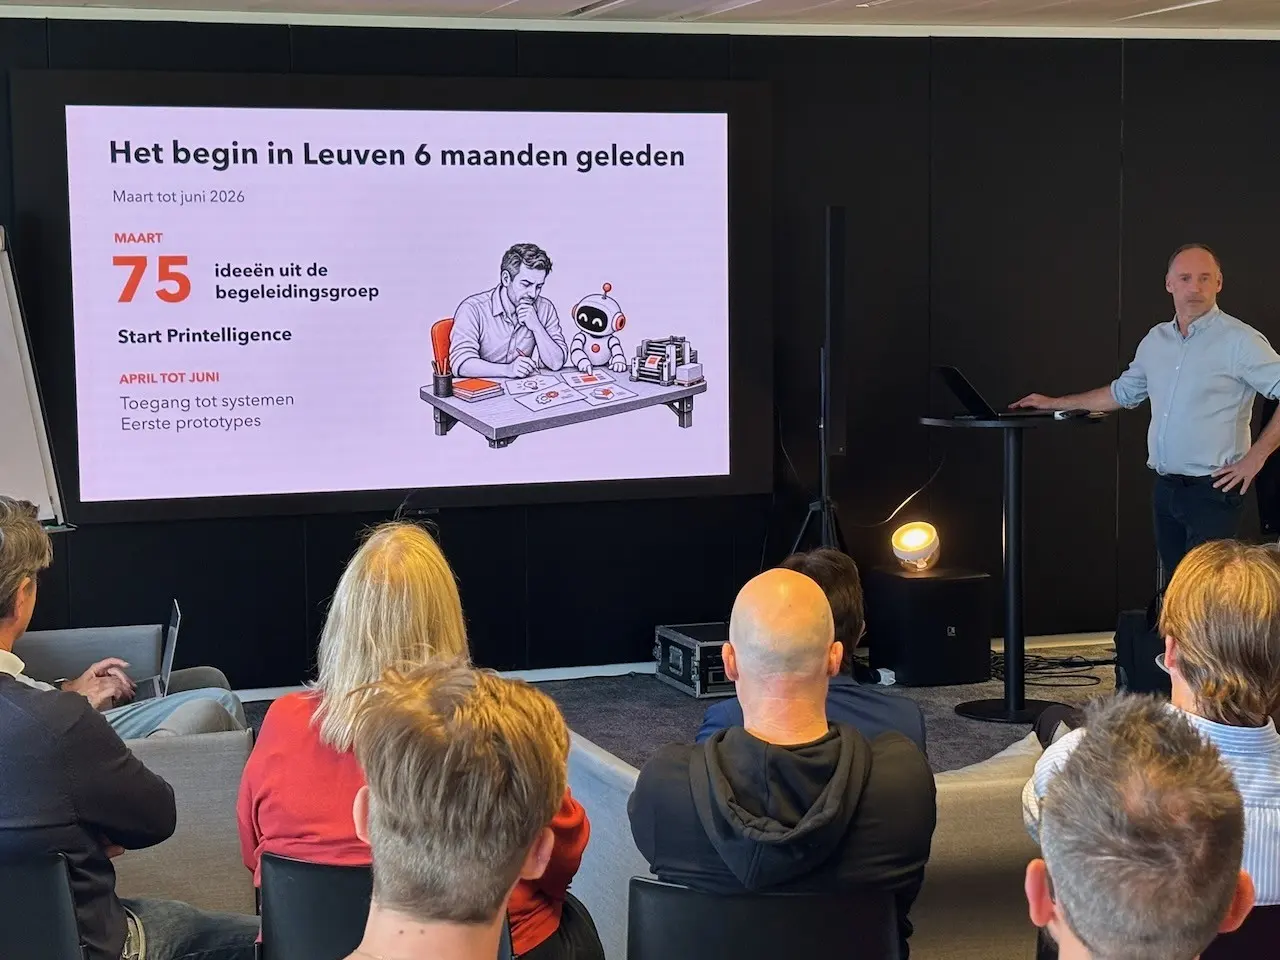
De eerste maanden van het project gingen vooral naar het fundament: toegang tot de data. Dat klinkt eenvoudig. In de praktijk vraagt het veel overleg.
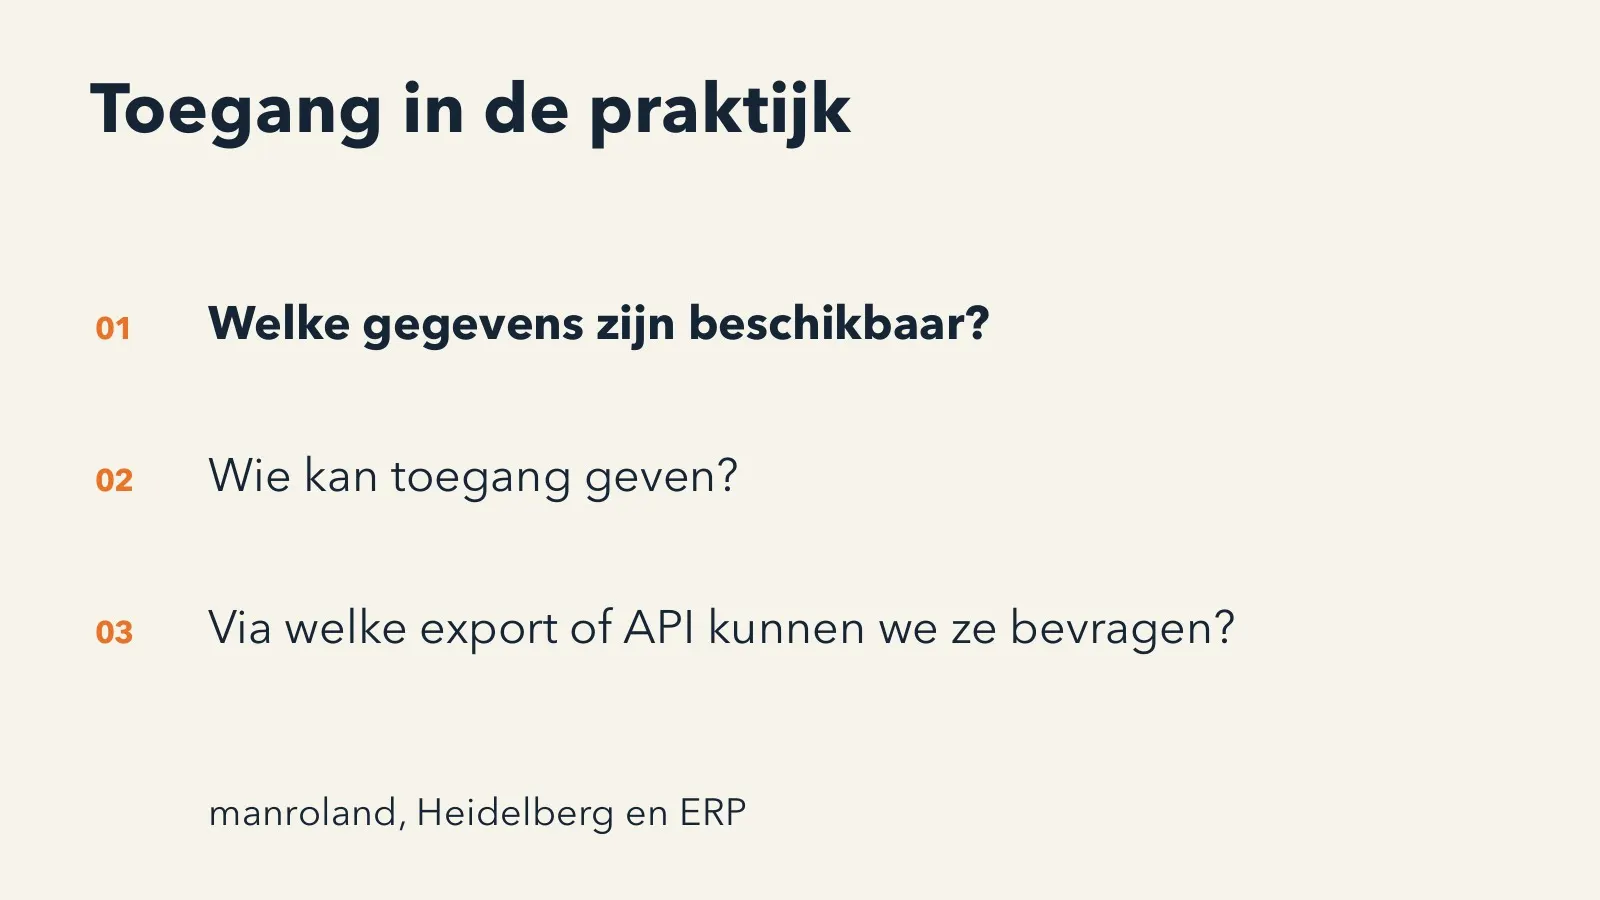
Voor de AI iets zinnigs kan zeggen over je productie regel je vier dingen.
Maak een lijst per bron. De tabel hieronder toont hoe het projectteam ze indeelt.
Soms is dat je eigen IT-verantwoordelijke. Vaak is het de leverancier van het ERP of de machinebouwer. In de proef bij Moderna ging het om overleg met twee machinebouwers: manroland en Heidelberg.
Een export is een bestand dat je uit het systeem haalt. Een API is een vaste koppeling waarlangs de AI zelf gegevens opvraagt. Voor de Heidelberg-vellenpers loopt dat bij Moderna via de Prinect-API.
De AI mag kijken en niets veranderen. In de proef was elke koppeling alleen-lezen. Zo kan een fout antwoord nooit een fout in de productie worden.
| Soort bron | Wat erin zit |
|---|---|
| Bedrijf | ERP en planning, joborders (JDF) |
| Productie | Rotatiepers, vellenpers, snijmachine, sensoren |
| Ervaring | Operatormeldingen |
Operatormeldingen voegen de ervaring achter de cijfers toe. Daarover gaat gids 13: de stem van de operator.
Goed om weten: bij Moderna toonde een haalbaarheidsstudie dat een moderne alleen-lezen API bovenop de bestaande ERP-databank werkt. Een overstap naar een ander ERP was niet nodig.
Antwoord met broncontrole
Een taalmodel kan zich vergissen en klinkt dan even zeker als anders. Daarom hoort bij elk antwoord een bron.
De rolverdeling is eenvoudig. De AI zoekt de relevante informatie via de koppelingen die beschikbaar zijn. De operator of de ploegleider controleert de bron en beoordeelt het voorstel.
Een goed antwoord toont vier dingen.
Het antwoord op de vraag, met de eenheid erbij.
Van wanneer tot wanneer er geteld is.
Uit welk systeem en welke tabel de gegevens komen.
De query of de formule, zodat iemand ze kan nalopen.
Waarom de operator? Hij weet wat de data niet weet. De pers lag dinsdag stil voor onderhoud. Er werd een nieuwe papiersoort getest. Een cijfer zonder die context leidt tot verkeerde besluiten.
Vuistregel: geloof geen cijfer waarvan je de bron niet kan openen.
Klein beginnen: een export in een rekenblad volstaat
Je hebt geen API nodig om dit te proberen. Een export en een AI-assistent zijn genoeg.
Neem een vraag die elke week terugkomt. De twee vragen hierboven zijn goede kandidaten.
Vraag een export uit je ERP of je perssoftware als Excel of CSV. Eén maand data is genoeg om te starten.
Upload het rekenblad en leg in twee zinnen uit wat elke kolom betekent. Staan er klantnamen of prijzen in? Gebruik dan een bedrijfsaccount waarbij je data niet dient om modellen te trainen. Je kan ook lokaal werken (zie gids 11).
Vraag niet alleen het cijfer. Vraag ook welke rijen geteld zijn en met welke filter.
Tel zelf in het rekenblad. Klopt het? Dan kan je de vraag elke week herhalen. Klopt het niet? Dan leerde je iets over je data of over je vraag.
In dit rekenblad staat elke stilstand van onze persen in september. De kolom “type” zegt wat er gebeurde. Hoeveel papierbreuken waren er per pers in de week van 21 september? Toon welke rijen je geteld hebt en welke filter je gebruikte.
Bewijst die wekelijkse vraag haar nut? Dan pas loont het om de export te vervangen door een vaste koppeling.
Vier valkuilen
De techniek is zelden het probleem. Het loopt mis bij afspraken en bij de data zelf.
Wat is waste precies? Tellen de instelvellen mee en reken je in vellen of in kilo's? Geven twee collega's een ander antwoord dan zit de AI er ook naast. Schrijf de definitie op voor je begint.
Een stilstand die niemand registreerde bestaat niet in de data. De klokken van twee systemen lopen niet altijd gelijk. De AI rekent met wat er staat en ziet niet wat ontbreekt.
Eén fout cijfer in een vergadering en niemand gebruikt het nog. Begin met vragen waarvan je het antwoord kan nalopen en toon altijd de bron. Zeg ook waarvoor de cijfers dienen: om de productie te verbeteren en niet om mensen te controleren.
Alle systemen tegelijk koppelen duurt maanden. Eén vraag op één bron levert deze week al iets op.
Verder bouwen: van export naar koppeling
Werkt de aanpak met een export? Dan helpen vier andere gidsen je verder.
Hoe systemen met elkaar praten en hoe je een eerste koppeling maakt.
Het formaat waarin de meeste API's hun gegevens teruggeven.
Je cijfers tonen op één scherm, gebouwd met vibe coding.
Een live dashboard op machinedata en API's.
Wil je dat een AI-assistent zelf aan je systemen hangt in plaats van aan een export? Dat gaat via MCP. De MCP-gids legt uit hoe.
Het project gaat ook verder op dit spoor. Een van de vier voorgestelde vervolgproeven heet “Bronnen koppelen”: de gegevens uit het ERP en de machinedata samen bevragen in plaats van elk apart.
Zelf proberen op 18 november. In Genk zie je in de voormiddag de resultaten live aan het werk. In de namiddag bouw je in een hands-on workshop zelf een dashboard op je productiedata.
Meer lezen en bronnen
Deze gids steunt op de presentatie “PRINTELLIGENCE: de eerste zes maanden” die het projectteam gaf op de tweede begeleidingsgroep, op 24 september 2026 in Hasselt. De twee werkvloervragen en de rolverdeling tussen AI en operator komen uit die presentatie. De voorbeelden over toegang komen uit het publieke verhaal van de eerste proof-of-concept bij Drukkerij Moderna.
De voorbeeldquery en het rekenvoorbeeld zijn door het projectteam toegevoegd als illustratie. Het zijn geen cijfers uit de proef. De stappen met een rekenblad zijn een advies van het team.
Alle 28 slides om door te bladeren of als pdf te downloaden, bij het verslag van begeleidingsgroep 2.
Welke bronnen er gekoppeld werden en waarom alles alleen-lezen bleef.
De 75 ideeën uit de sector. “API's beter benutten” en “data uit diverse bronnen samenbrengen” stonden er toen al bij.
Wat de meldingen van je operatoren toevoegen aan de cijfers.
De AI zoekt de informatie en de operator controleert de bron. De werkvraag blijft het vertrekpunt.